Evaluation
「精度は何%ですか」に、
ひとつの数字で答えない理由。
同じ画像・同じモデルでも、線をどこに引くかで答えが変わります。 だから当社は、ひとつの数字ではなく分布と、動作点と、母集団で答えます。
このページは、評価の数字をどう読むか、そして運用に入ってから何が起きるかを、 実際の評価出力とその場の計算で確かめるためにあります。
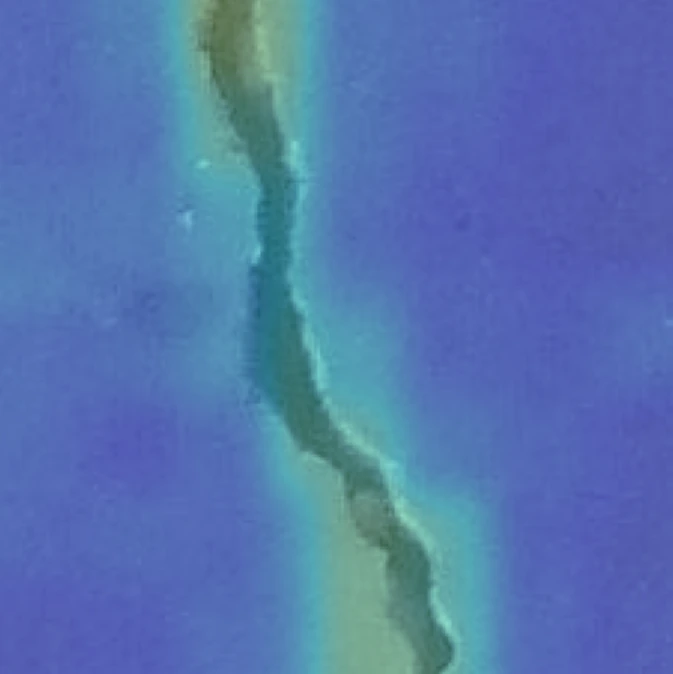
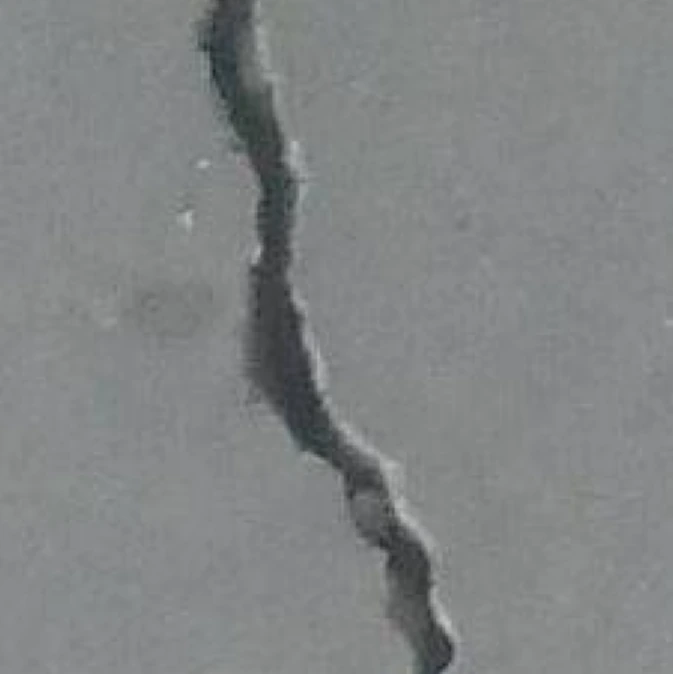
◀ ドラッグして比べる ▶
この 1 枚の異常スコアは 0.55。 しきい値を 0.38 に置けば NG、0.60 に置けば OK。 画像もモデルも変えていません。
Experiment 01
見逃しと過検出は、
同時には減らない。
しきい値を下げれば見逃しは減りますが、良品を NG と呼ぶ数が増えます。 上げればその逆です。両方を同時にゼロにする設定はありません。
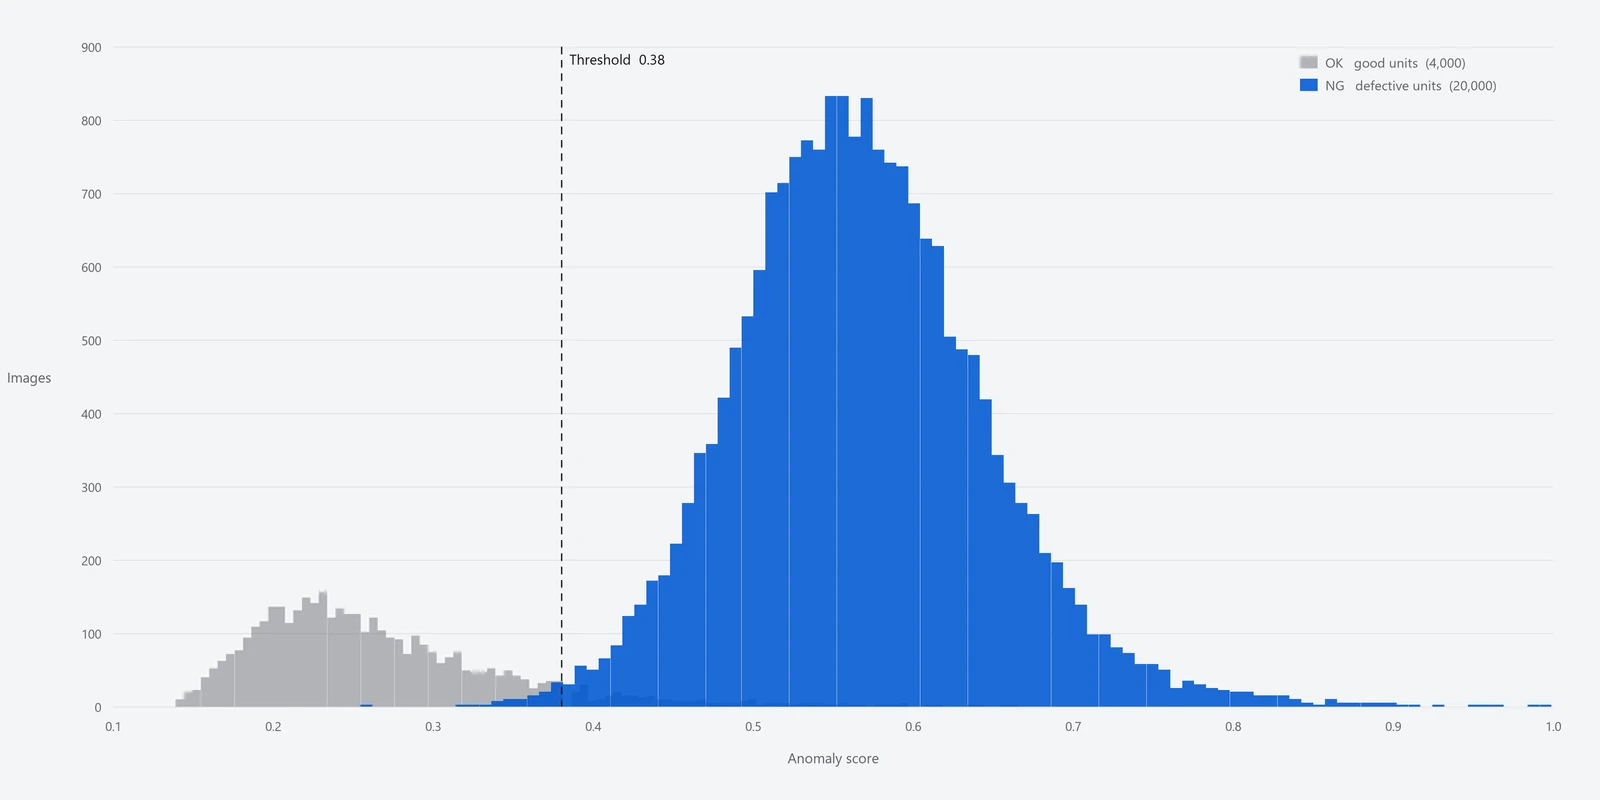
下では、公開データセットに対する当社の評価から得たスコア分布の上でしきい値を動かし、 そこに現場の不良率と1 日の生産数を掛けて、実際の個数に直しています。
左下に近いほど良い設定です。曲線に沿ってしか動けません。
| OK と判定 | NG と判定 | |
|---|---|---|
| 本当は良品 | — | — 過検出 |
| 本当は不良 | — 見逃し |
— |
—
0.38
1.0 %
見逃し率(不良のうち) —
過検出率(良品のうち) —
適合率(NG のうち本物) —
曲線は、公開データセット Özgenel (2018) Concrete Crack Images for Classification (Mendeley Data V2・CC BY 4.0)に対する当社の評価出力のヒストグラムから読み取った分布で描いた概算です。 図中の ◯ は実測点で、評価出力の混同行列そのもの(しきい値 0.38/ 良品 4,000 枚中 291 枚を NG と判定=過検出 7.3%/不良 20,000 枚中 97 枚を見逃し=0.49%)。 読み取りの誤差の分だけ、曲線と ◯ はわずかにずれます。不良率と生産数は、あなたが置いた仮定です。
不良率を下げてみてください。
不良率 0.1% にすると、NG と判定された箱の中身がほとんど良品になります。 モデルは何も変わっていません。変わったのは母集団だけです。
「NG と言われたのに良品ばかり出てくる」という現場の声は、多くの場合これです。 過検出率が低くても、不良そのものが少なければこうなります。
どちらを優先するかは、工程が決めます。
流出が致命的な工程では見逃しを最小にし、過検出は人手で戻します。 後工程で気づける不良なら、過検出を減らして手間を軽くする側に寄せます。
この判断は装置ではなく、不良が流出したときの損失と 1 個を人が見直す手間の比較で決まります。だから当社は動作点を勝手に決めません。
※ ここで動かせるのは不良率などの仮定までで、分布そのものは当社の実測値に固定しています。 分布のほうを自分で作って、しきい値の決め方(F1 最大/見逃しゼロ優先/過検知率の上限/現場コスト最小化)まで 試したいときは、公開しているデモをどうぞ ── LAB →
Four numbers
4 つの数字は、
別のことを言っている。
同じ 1 回の評価から、少なくとも 4 つの「率」が出ます。 どれも正しく、どれも別のことを言っています。
分母が違います。見逃し率と過検出率はモデルと動作点だけで決まりますが、 適合率と正解率は現場の不良率で動きます。
不良率 0.1% の工程なら、 すべてを OK と判定するだけで正解率は 99.9% になります。 正解率が高いことは、何かを見つけた証拠になりません。
同じ表から取り出す率でも、分母が違えば別のことを言っている。 商談で「精度」と呼ばれているのは、たいていこのどれかです。
Experiment 02
5 枚で全部当てても、
「99%」とは言えない。
評価に使った不良が少ないと、出てきた数字の幅が大きくなります。 下は、検出できた枚数から真の検出率が入りうる範囲(95% 信頼区間)を計算したものです。
算数だけで決まる話で、モデルの良し悪しとは関係ありません。 「実績があるなら精度を出してほしい」と言われたときに、当社が枚数から先に話す理由です。
5 枚
0 枚
見かけの検出率 —
真の検出率の 95% 範囲 —
—
「99% 以上」と言うのに要る枚数。
不良を 1 枚も見逃さなかったとして、真の検出率の下限が 99% を超えるには 500 枚前後が要ります(500 枚で下限 99.2%)。100 枚では 96.3% までしか言えません。
当社のサイトに載せている実案件の実測は、不良 5 枚・7 枚・9 枚といった規模です。 そこから「精度 100%」とは書けません。書いていないのは、書けないからです。
枚数が集まらないときは。
不良は、本来めったに出ないものです。評価に足りる枚数が集まらない工程のほうが普通です。
その場合は精度を約束するのではなく、Human_Check の帯を広く取り、 運用しながら実物の不良を集めて、あとから較正し直します。 しきい値を置く体験 →
Measured
実際の評価出力は、
こう出ています。
上の体験で使っている分布のもとになった評価です。 公開データセットなので、誰でも同じ手順で確かめられます。
| データセット | Özgenel (2018) Concrete Crack Images for Classification Mendeley Data V2 / CC BY 4.0 |
|---|---|
| 評価枚数 | 24,000 枚(良品 4,000 / 不良 20,000) |
| しきい値 | 0.38(F1 が最大になる点として算出) |
| 混同行列 | 良品 4,000 → OK 3,709 / NG 291 不良 20,000 → OK 97 / NG 19,903 |
| 検出率(再現率) | 99.5 %(19,903 ÷ 20,000) |
| 見逃し率 | 0.49 %(97 ÷ 20,000) |
| 過検出率 | 7.3 %(291 ÷ 4,000) |
| 適合率 | 98.6 %(19,903 ÷ 20,194) |
| AUC | 0.992 |
| 対象物 | コンクリート表面。金属部品ではありません。 この数字を他の対象物へ一般化できません |
この評価の良品側は 4,000 枚あるので、過検出率 7.3% は狭い幅で言えます。 一方、実案件では良品も不良も枚数が限られます。 数字はいつでも「何枚で測ったか」とセットで読んでください。
In operation
動き出してからのほうが、
長い。
評価は始まりです。運用に入ると、評価では出なかったことが出ます。 そのときに何をするかを、先に決めておくのが導入設計です。
手は 3 つです。しきい値を上げる(見逃しが増えます)/ 良品を追加で学習させる(今まで見ていなかった正常のばらつきを覚えさせる)/ 見る範囲を絞る(判定に関係ない領域を外す)。 どれを選ぶかは、増えた過検出がどこに出ているかで決まります。
その 1 個を評価データに加えるのが最初です。 しきい値を下げる前に、その不良のスコアがいくつだったかを見ます。 スコアが低ければ、しきい値ではなく撮り方の問題である可能性があります (→ 対象物別の見え方)。
照明を替えた、ロットが替わった、装置を移設した。 覚えていない変化はすべて「異常」として出ます。 良品の分布ごと動くので、しきい値の微調整ではなく学習し直しが要ります。
機械が決めきれない帯を人に返す仕組みです。 帯を広げれば流出は減り、人が見る枚数は増えます。 1 日に人が見られる枚数から逆算して帯を決めるのが、いちばん現実的な置き方です。
当社は精度を保証しません。保証できるのは、同じ入力に同じ答えを返すことと、 判断に使った数字をすべてお見せすることです。 どの動作点で運用するかは、流出の損失と人手の比較で決まるお客様の判断であり、 その判断に必要な材料を出すのが当社の仕事だと考えています。
Where it sits
数字が出てくるのは、
判定の層。
評価の数字は判定エンジンから出ますが、その良し悪しは 手前のセンサの層でどれだけ差が付いているかに左右されます。
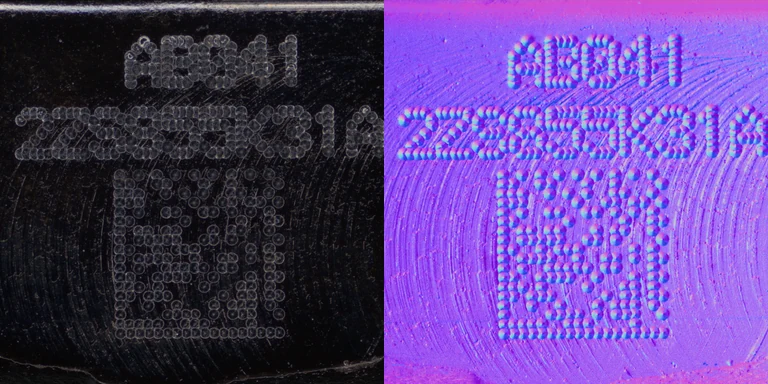
どの出力を判定に渡すかで、分布の重なり方が変わります。同じ対象でも Live と Surface Normal で結果が違います。
スコアと 3 値判定(OK / Human_Check / NG)を返します。 このページの数字はすべてこの層の出力です。
判定結果を現場の動作につなぎます。Human_Check をどこへ流すかは、 ラインの構成で決まります。
Contact
どこに線を引くかは、
工程が決めます。
見逃したときの損失と、1 個を人が見直す手間。この 2 つが分かれば、 動作点は決められます。お預かりしたサンプルで評価を回し、 分布と混同行列をそのままお見せするところからご相談ください。