「良品だけのはず」の学習データにNGが混じったら、検査AIはどうなるか
 kotai2003
外観検査AIを作るとき、多くの手法は「学習データは全部良品」という前提に立つ。しかし現場ではラベルミスや検品漏れで、不良品の画像が数枚だけ学習用フォルダに紛れ込むことがある。この前提が崩れたとき、モデルはどこまで壊れるのか。SoftPatch(NeurIPS 2022)は、その崩れ方と防ぎ方を検証した論文である。
PatchCoreの弱点を塞ぐ一手間
土台となるのはPatchCoreという代表的な手法だ。学習画像を小領域(パッチ)に分け、その特徴を「メモリバンク」という辞書に保存しておき、検査時はテスト画像の各パッチと辞書の中で一番近い特徴との距離を異常度とする。似た特徴が辞書になければ「見たことがない=異常」と判定する仕組みである。
問題は、この辞書に不良パッチが混ざった場合だ。似た不良が検査時に来ると、辞書と一致してしまい「見たことがある=正常」と誤判定される。しかもPatchCoreの辞書作りは、特徴空間をまんべんなくカバーするよう代表点を選ぶ方式のため、特異な特徴、つまり外れ値である不良パッチをむしろ優先的に拾いやすい。
SoftPatchが加えたのは、辞書を作る前にパッチ単位で怪しいものを取り除く一手間である。画像丸ごと捨てるのではなくパッチ単位で判定するため、不良画像に含まれる正常な部分は無駄にせず活用できる。判定にはLOF(局所外れ値因子)という、周囲のパッチとの密度の比で「浮いている度合い」を測る手法を使う。さらに、除去しきれなかった紛らわしい不良に備え、残した各特徴に外れ度に応じた重み(soft weight)を持たせ、検査時の距離計算に掛け合わせる。
図1のとおり、PatchCoreとの違いは辞書を作る前の除去と、辞書に添える重みの2点である。
flowchart LR
  subgraph PC["PatchCore(従来)"]
    direction TB
    A1["学習画像のパッチ特徴<br/>(紛れ込んだ不良パッチを含む)"] --> A2["代表点を選んで辞書を作る"]
    A2 --> A3["辞書(メモリバンク)<br/>不良パッチが残りうる"]
    A3 --> A4["検査時: 最も近い特徴との距離=異常度"]
  end
  subgraph SP["SoftPatch"]
    direction TB
    B1["学習画像のパッチ特徴<br/>(紛れ込んだ不良パッチを含む)"] --> B2["位置ごとにLOFで外れ度を測り<br/>外れ度の高いパッチを除去"]
    B2 --> B3["残りから代表点を選んで辞書を作る"]
    B3 --> B4["辞書+各特徴の外れ度に応じた重み<br/>(soft weight)"]
    B4 --> B5["検査時: 最も近い特徴の重み × 距離=異常度"]
  end

  PC -->|改良| SP
図1 処理の比較(論文本文の説明をもとに作成)
論文自身による全体図が図2である。
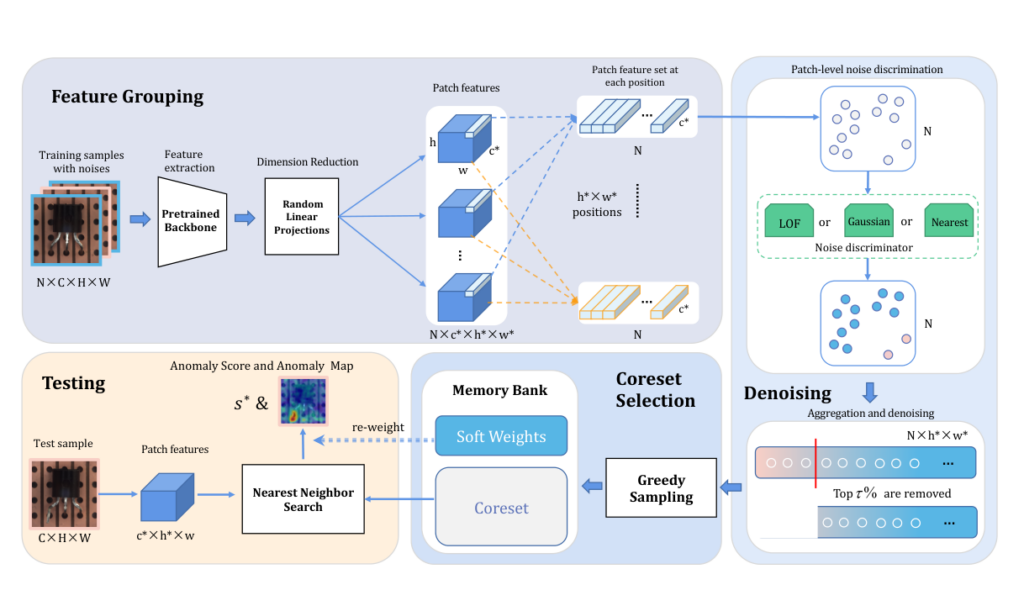
SoftPatchの全体像。学習時に特徴マップの位置ごとにLOFなどで不良らしいパッチを判定し、外れ度の上位を除去してから代表点を選び、辞書とsoft weightをメモリバンクに保存する。検査時は最近傍探索の距離をsoft weightで重み付けして異常度と異常マップを出す
図2 出典: Jiang et al., "SoftPatch: Unsupervised Anomaly Detection with Noisy Data", NeurIPS 2022 — Figure 2。arXiv:2403.14233(arXiv non-exclusive license。引用として無改変で掲載。図中の製品画像はMVTec AD由来)
「NGを入れてはいけない」根拠と、その条件
この論文が露呈させるのは、NG混入の影響が検証条件で大きく変わるという事実である。学習データに不良画像を混ぜたうえで、その不良画像そのものをテストにも残す条件(Overlap、最悪ケース)と、テストからは除く条件(No overlap、緩いケース)を比較している。
Overlap・混入率10%では、PatchCoreの画像AUROC(1.0が完全、0.5が当て推量)が0.992から0.683まで落ちる。一方SoftPatchはほぼ無傷で0.982を維持する。混入率を15%まで上げると、Overlapの下でPatchCoreの低下は著者報告で最大40%に達する。主要な数値を表1にまとめる。
| 条件(MVTec AD 15カテゴリ平均・3回平均。混入率は10%(参考行を除く)) | 指標(AUROC) | PatchCore | SoftPatch |
|---|---|---|---|
| 混入なし(参考。原論文の表の「差」から算出) | 画像(検出) | 0.992 | 0.986 |
| No overlap(混入した不良画像はテストに出ない) | 画像(検出) | 0.984 | 0.986 |
| Overlap(同じ不良画像がテストにも出る) | 画像(検出) | 0.683 | 0.982 |
| 混入なし(参考。原論文の表の「差」から算出) | ピクセル(位置特定) | 0.981 | 0.981 |
| No overlap(混入した不良画像はテストに出ない) | ピクセル(位置特定) | 0.956 | 0.979 |
| Overlap(同じ不良画像がテストにも出る) | ピクセル(位置特定) | 0.654 | 0.969 |
表1 原論文Table 1・2より
ただし、Overlapは極端な条件である。No overlapでは、混入率を上げてもPatchCoreの低下はわずかにとどまる。「少数のNGが紛れても即座に壊滅するわけではない。だが同じ不良画像が学習とテストの両方に現れると、辞書に入り込んだNGが牙をむく」というのが実態であり、これが「NGをそのまま辞書に入れてはいけない」根拠になる。
なお要素分解では、改善の大半はLOFによる除去そのものが生んでおり、soft weightの上乗せ効果は指標によって上下し、著者自身も「軽微」とする。また学習データにNGが全く無い理想条件では、SoftPatchは画像AUROCでPatchCoreにわずかに劣る。除去の閾値をやや保守的に設定している代償とみられる。
実務への含意と限界
現実の多くの現場は、最悪設定のOverlapとNo overlapの中間にあると考えられる。閾値やLOFの近傍数は固定値で、対象や混入率によって最適値は変わりうると著者も認めている。検証した混入率も最大15%までで、NGが多数派に近づく状況は想定外だ。
学習データの目視によるNG完全排除に頼るより、パッチ単位の自動除去を検査パイプラインに組み込む方が現実的な保険になる。処理時間もPatchCoreとほぼ同じで、導入のハードルは高くない。また、実データセットBTADで学習画像に傷が元から混じっていたカテゴリでもSoftPatchはPatchCoreを上回っており、合成実験に限らない効果も確認されている。ただしSoftPatchはNGを積極的に活用する手法ではなく、あくまで取り除く手法である点は誤解しないほうがよい。
出典
Jiang, Liu, Wang, Nie, Wu, Liu, Wang, Zheng. "SoftPatch: Unsupervised Anomaly Detection with Noisy Data." NeurIPS 2022. arXiv:2403.14233
