論理異常検出の順位は、人工的な撮影変化を混ぜると入れ替わる
 kotai2003
製造ラインの外観検査では、AIが「正常品との違い」を探して不良を見つけます。部品の欠品や誤配置といった規則違反を探す課題を論理異常検出と呼びます。傷や汚れなど見た目の欠陥を探す構造異常検出とは別の課題です。標準ベンチマークの MVTec LOCO では、AUROC(正常と異常をどれだけ分けられるかを表す指標で、50%が偶然、100%が完全)がほぼ満点の手法が出ています。ただし、その成績は撮影条件が一定の画像で測られたものです。実際のラインでは照明もカメラ位置も変わります。Efe と Temizel の論文は、この「条件の揺れ」を試験に加えると順位が変わることを示しました。
順位表は一つの試験の結果にすぎない
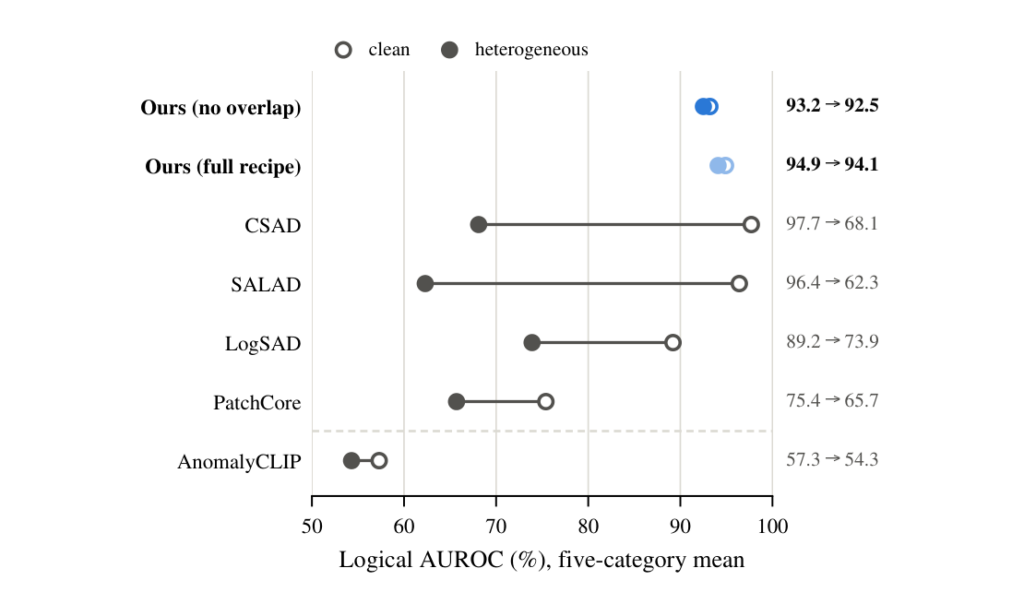
著者らは、テスト画像ごとに7条件のどれかを無作為に割り当てて混ぜました。内訳は、無加工、明るさを0.8/0.6/0.4倍に下げる3段階、画像を5/10/15%縮小する3段階(zoom-out)です。混ぜた全体で AUROC を1つ計算します(無作為割り当て100回の平均)。実機は条件によらず同じしきい値を使うためです。一方、無加工の画像だけで測った値を clean と呼びます(混在の平均ではありません)。図1は、5カテゴリ平均の clean と混在時の差を示します。
出典: Ufuk Efe, Alptekin Temizel, "Robust Logical Anomaly Detection under Capture Shifts via Synthetic Anomalies", Figure 1。https://arxiv.org/abs/2610.18295(arXiv non-exclusive license。引用として無改変で掲載)
clean で首位級の CSAD は 97.7 から 68.1 へ下がりました。SALAD も 96.4 から 62.3 へ下がりました。この2手法は、混在では LogSAD(89.2 から 73.9)にも抜かれます。clean の順位表だけでは、この入れ替わりは見えません。
崩れる理由と、提案法の発想
崩れる手法は、正常な学習画像からの距離で採点します(著者は normal-reference 法と呼びます)。著者の説明では、暗い画像や小さく写った物体は部品が正しくても正常から遠く見え、異常寄りに採点されます。論文の分析では、強い摂動下で CSAD と SALAD の正常画像の大半が、clean な異常画像の中央値より高いスコアになります。
提案法は正常画像と比べずに判定します。図2の上段では、人が書いた製品説明から LLM が異常タイプと編集指示を作ります。画像編集モデルが正常画像を加工し、VLM の補助を受けて人が有効な編集だけを残します。例の Pushpins では「15区画に画鋲が1本ずつ」に反するよう、1区画に2本入った画像を作っています。下段では正常画像を似たもの同士の群に自動で分け、分類器に正常の群と異常タイプを見分けさせます。正常以外の確率の合計が異常スコアです。
](https://www.tomomi-research.com/wp-content/uploads/2026/10/CaptureShift_figure2-1024x656.png)
出典: Ufuk Efe, Alptekin Temizel, "Robust Logical Anomaly Detection under Capture Shifts via Synthetic Anomalies", Figure 2。https://arxiv.org/abs/2610.18295(arXiv non-exclusive license。引用として無改変で掲載)。写真は MVTec LOCO AD(Pushpins。Bergmann et al., IJCV 2022、CC BY-NC-SA 4.0)の正常画像と、その生成AI編集版。
次の図は図2の簡略版です。
flowchart TB
  A["製品の説明文"] --> B["LLM が異常タイプと<br/>編集指示を作る"]
  B --> C["画像編集モデルが<br/>正常画像から合成異常を作る"]
  C --> D["VLM の補助で人が確認し<br/>有効な編集だけ残す"]
  N["正常画像"] --> C
  N --> E["正常画像を似たもの同士の<br/>群に自動で分ける"]
  D --> F["分類器を学習<br/>正常群+異常タイプ"]
  E --> F
  F --> G["正常以外の確率の合計<br/>=異常スコア"]
  class A,D,E,N neutral
  class B,C core
  class F judge
  class G out
  classDef neutral fill:#F5F5F5,stroke:#757575,stroke-width:1px,color:#1B1B1B
  classDef core fill:#FFCC80,stroke:#BF360C,stroke-width:3px,color:#1B1B1B
  classDef judge fill:#E3F2FD,stroke:#1565C0,stroke-width:2px,color:#1B1B1B
  classDef out fill:#EDE7F6,stroke:#4527A0,stroke-width:1px,color:#1B1B1B
分類器は「正常の証拠」(編集前の正常画像)と「違反の証拠」(その編集版)を見比べて学びます。どちらも、おおむね同じ撮影条件で撮った画像です。そのため暗さや縮小は両方の証拠に同じように効き、判定がどちらか一方へ偏りにくい、というのが著者の見立てです。著者自身も未検証の仮説としています。学習に残した blur やノイズなどの汎用的な増強が効いている可能性も挙げられています。
結果と、読み替えてはいけない点
| 手法 | clean | 混在 | 低下 |
|---|---|---|---|
| CSAD | 97.7 | 68.1 | 29.6 |
| SALAD | 96.4 | 62.3 | 34.1 |
| LogSAD | 89.2 | 73.9 | 15.3 |
| PatchCore | 75.4 | 65.7 | 9.7 |
| 提案法(full recipe) | 94.9 | 94.1 | 0.8 |
| 提案法(no overlap) | 93.2 | 92.5 | 0.7 |
数値は MVTec LOCO の論理異常、画像単位 AUROC(%)、5カテゴリ平均です。比較手法は公開重みで再学習なしの再測定値です。低下は clean と混在の差で、当方の計算です。SALAD だけは、clean 画像用に公開された構成マップを使っています。摂動の影響を受けない分、SALAD に有利な条件です。
full recipe は、テスト摂動と同じ範囲の明るさ・zoom 増強を学習に含む標準構成です。no overlap はその増強を学習から外した版で、著者は頑健性の主張をこちらに置いています。clean では提案法(full recipe)は CSAD・SALAD を1.5〜2.8pt下回ります。
実務で使うときの注意
まず、摂動は人工の2系統だけです。実撮影のセンサノイズ、照明ムラ、物体の位置ずれは試していません。次に、混在試験ではテスト画像の約6/7が摂動を受けます。この AUROC を、量産ラインの見逃し率や誤報率へ読み替えてはいけません。さらに MVTec LOCO 1種、単一シードでの結果で、構造異常は対象外です。著者自身、撮影が厳密に管理されたラインなら normal-reference 法のほうがよいとしています。
自社ラインで使うなら、clean の順位に加え、実際の照明・位置の変動幅を人工摂動で再現できているかを先に確認したいところです。
低下の内訳も手法で違います。CSAD の低下は主に個々の条件の中で、SALAD は主に条件間のスコアのずれで生じます。たとえば暗い画像群だけが全体に高得点になるのが、条件間のずれです。著者によれば、後者は照明・カメラ配置を監視して条件を判別できれば条件別のしきい値で補えますが、前者は直りません。
人が書く製品説明に依存する点も、異常タイプの網羅性という論点として残ります。推論時間や生成の費用、人手の工数は論文に記載がありません。
出典
- Ufuk Efe, Alptekin Temizel, "Robust Logical Anomaly Detection under Capture Shifts via Synthetic Anomalies", arXiv:2610.18295v1(2026年、プレプリント・査読前) https://arxiv.org/abs/2610.18295
- 図2中の画像のデータセット: Bergmann et al., "Beyond Dents and Scratches: Logical Constraints in Unsupervised Anomaly Detection and Localization", International Journal of Computer Vision (IJCV), 2022。MVTec LOCO AD(https://www.mvtec.com/company/research/datasets/mvtec-loco)、ライセンス CC BY-NC-SA 4.0。図中の編集画像は、論文の著者が画像編集モデル(Gemini 3 Pro Image)で生成したものです
